Онлайн-персонализация каталога Lamoda
Каталог должен упорядочить все товары под фильтрами, а не выдать короткий список. Заранее рассчитать каждую комбинацию пользователя и фильтров трудно. Lamoda добавила персональное ранжирование верхней части выдачи и выделила переиспользуемые компоненты обучения и применения.
Видео · на русском
Новый уровень ML-персонализации Lamoda: как мы усилили ее в каталоге / Дана ЗлочевскаяДана Злочевская · Опубликовано: 12 марта 2026 г.
Исходный доклад · Открыть оригинал
Каталог отличается от рекомендаций
Пользователь выбирает размер, бренд, цвет или вводит запрос и ожидает возможность листать весь подходящий ассортимент. Поэтому первый уровень ранжирует каталог целиком, а дорогую онлайн-персонализацию применяют к верхним кандидатам. В выступлении описано расширение их числа со 150 до 300.
Базовый порядок обеспечивает продолжение выдачи. Фильтры применяются до передачи кандидатов персональному ранжировщику.
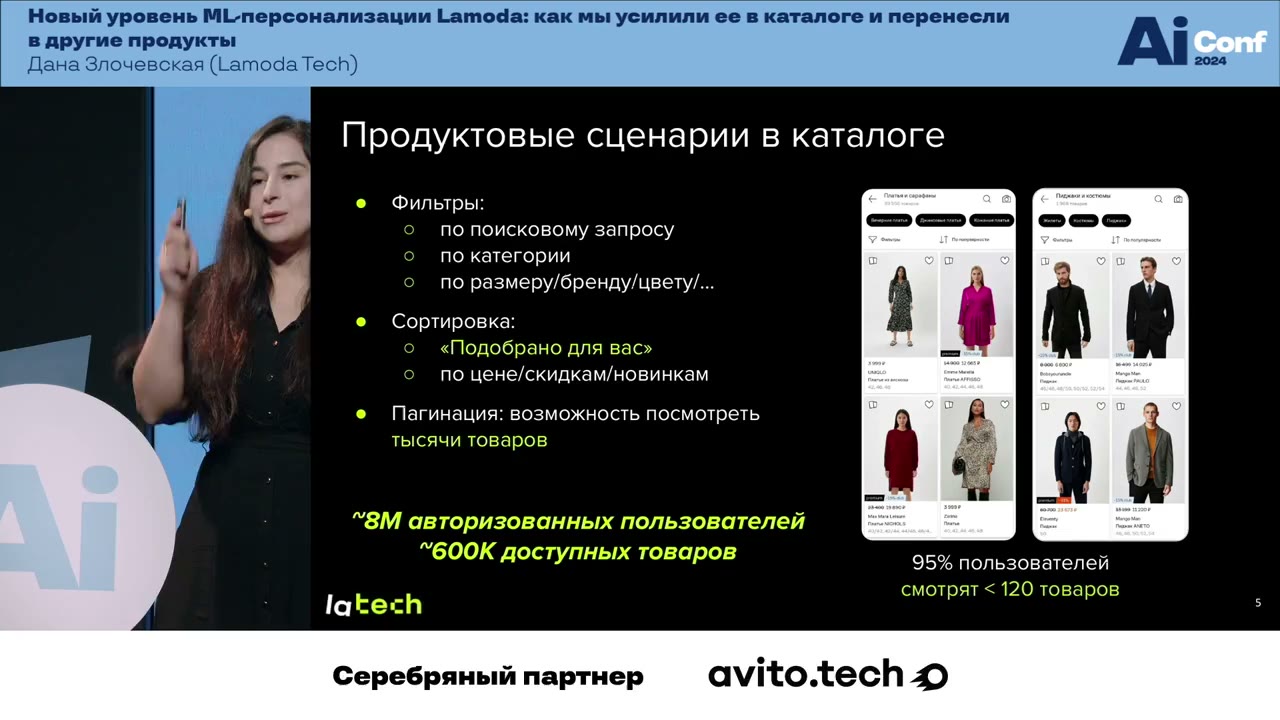
Сценарии персонализации каталога.
Источник: Кадр из докладаПочему целевое действие — корзина
Красивый товар может привлечь клик, но не подойти по размеру. Добавление в корзину ближе к задаче выбора доступной покупки. CatBoost обучают на реально увиденных пользователем товарах, а не просто на объектах, отправленных сервером.
В признаки входят свойства товара, история пользователя и их взаимодействия, например предпочтения по брендам и цветам. Некоторые более сложные цели улучшали offline-метрики, но не дали подтверждения онлайн.
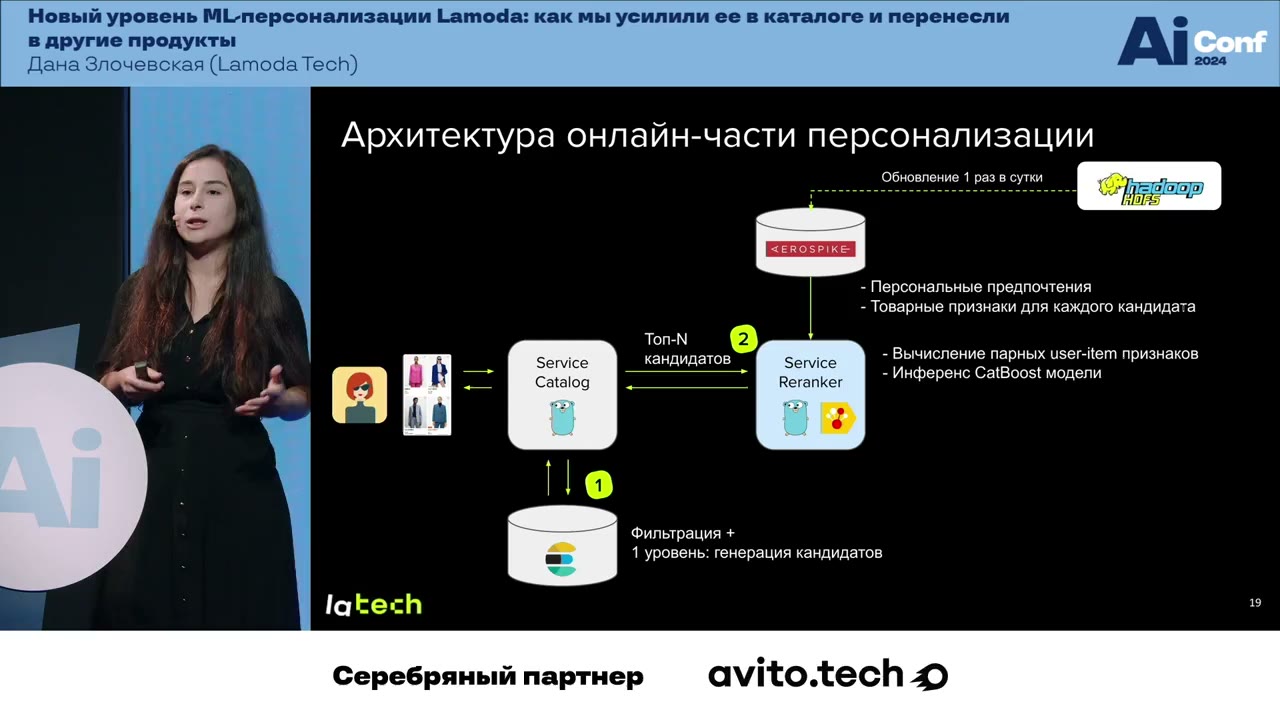
Архитектура онлайн-персонализации.
Источник: Кадр из докладаОбщие компоненты вместо одной модели на всё
Для переноса опыта унифицировали подготовку событий, признаков и обучение. В Go-сервисах переиспользуют компоненты загрузки моделей и чтения данных, сохраняя возможность доработки под продукт.
Прямой перенос бинарной модели каталога на полку рекомендаций ухудшил offline-качество. Переобучение на показах полки помогло, а признаки якорного товара дали дополнительное улучшение. Общая инфраструктура не отменяет разницы обучающих задач.
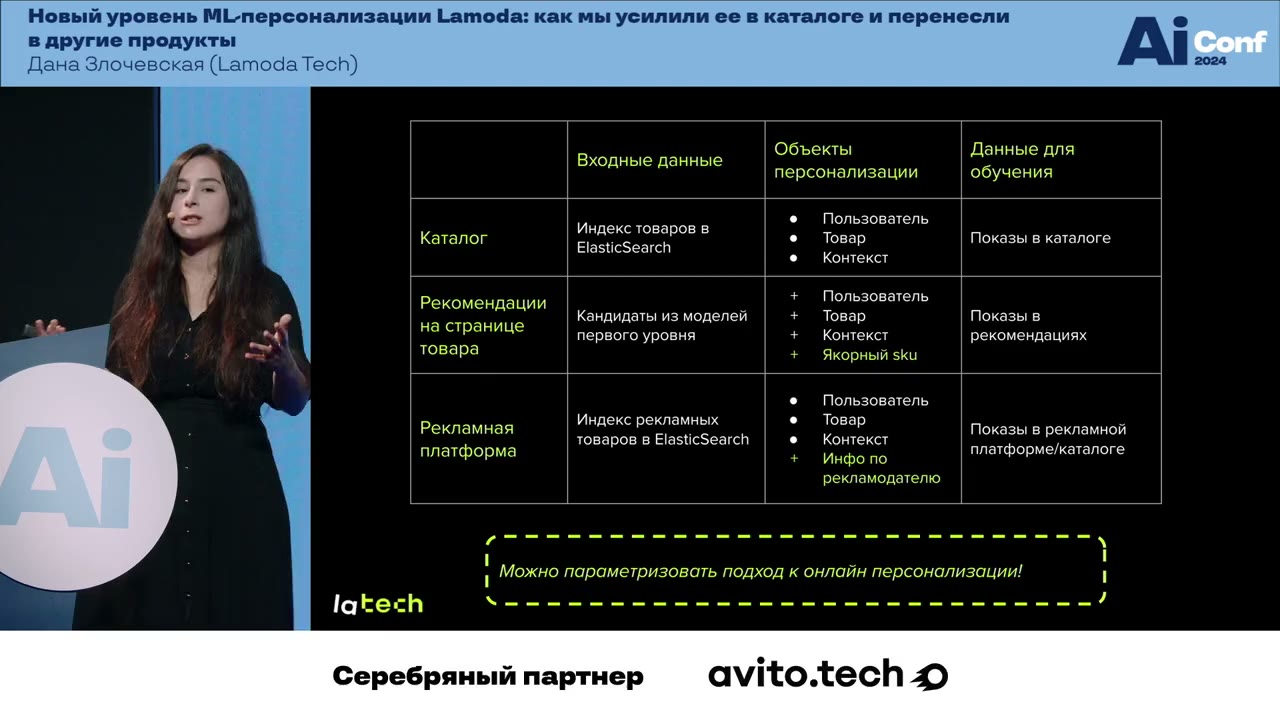
Различия между продуктовыми поверхностями.
Источник: Кадр из докладаПризнаки нужно записывать в момент применения
Восстановленные позже значения могут отличаться от тех, которые видела модель. Для динамических признаков команда переходит к логированию во время запроса. При этом набор записываемых признаков отделяют от конкретной модели A/B-группы, иначе обучающие данные окажутся несовместимыми.
Большой поток требует выборочного сохранения и подходящей обработки. Также нужно учитывать, что логи персонального ранжировщика охватывают только сессии, где он запускался.
25:00 — фрагмент докладаЧто было запущено к выступлению
Персонализация каталога прошла успешные A/B-тесты, включая расширение покрытия на поиск. Новую рекомендательную полку ещё тестировали. Видео загружено в 2026 году, но относится к AiConf 2024: статус экспериментов описывает именно момент выступления.
29:00 — фрагмент доклада