Эволюция рекомендаций hh.ru: от фильтров до трансформеров
Нужно подобрать не просто похожую вакансию, а полезную встречу кандидата и работодателя, учитывая ликвидность рынка. Станислав Яркин разбирает отбор кандидатов, ранжирование, текстовые и поведенческие модели по оригинальным слайдам.
Слайды · на русском
Эволюция рекомендательной системы hh.ru: от линейной регрессии к трансформерам по тексту и поведениюОткрыть оригинальные слайдыСтанислав Яркин · Опубликовано: 16 мая 2025 г.
Воронка и ограничения рынка
Предварительные фильтры балансируют полноту, точность и нагрузку. Затем работают источники кандидатов и ранжирование. Жёсткое одинаковое top-K не учитывает разный размер профессиональных микрорынков.
Ранжировщик развивали преимущественно новыми признаками. В показанном эксперименте нейросетевая замена не дала локального улучшения — слайды не описывают линейную историю, где каждая новая архитектура обязательно лучше.
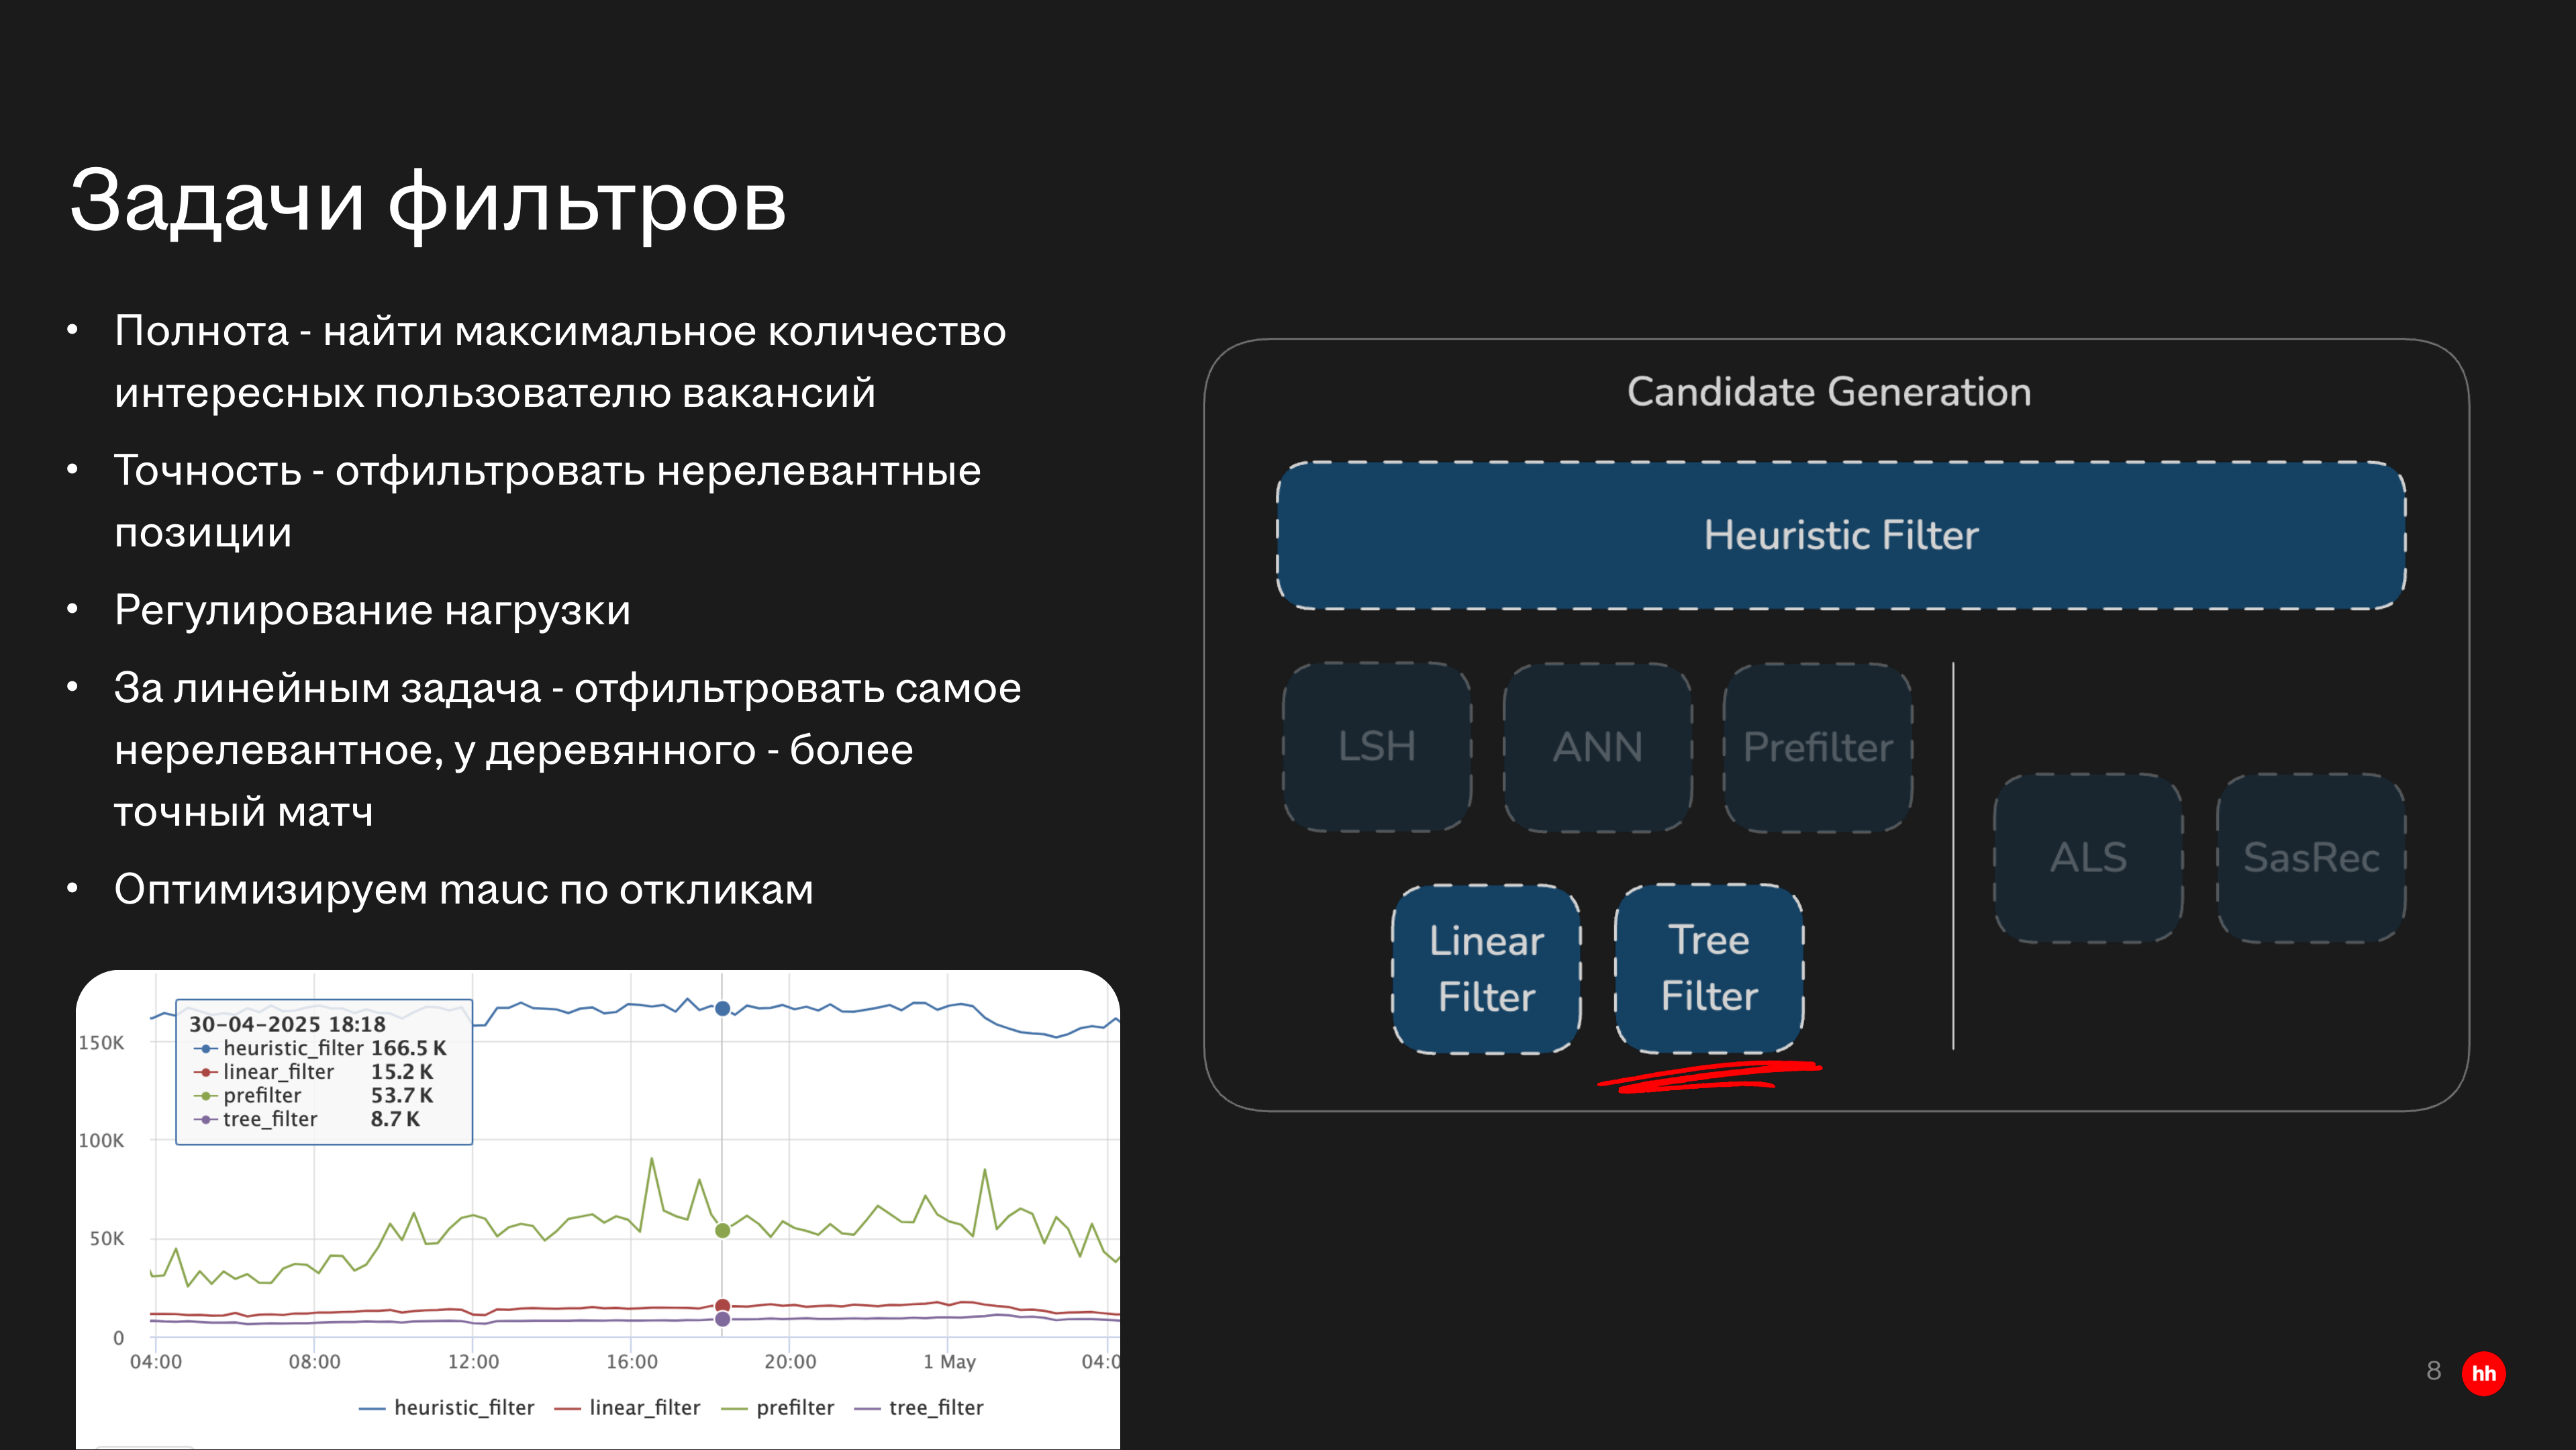
Фильтры в воронке рекомендаций.
Источник: Оригинал, страница 8Отклики нужно распределять
Часть вакансий почти не получает откликов. Для управления ликвидностью выделяют позиции под вакансии, рискующие оказаться в этой группе. Это позволяет отдельно наблюдать за продвигаемыми объектами.
На финальном этапе также решают задачи новых вакансий, дублей и работодателей, которые не разбирают отклики. Такие правила требуют прозрачной системы, иначе управление выдачей превращается в набор несогласованных поправок.
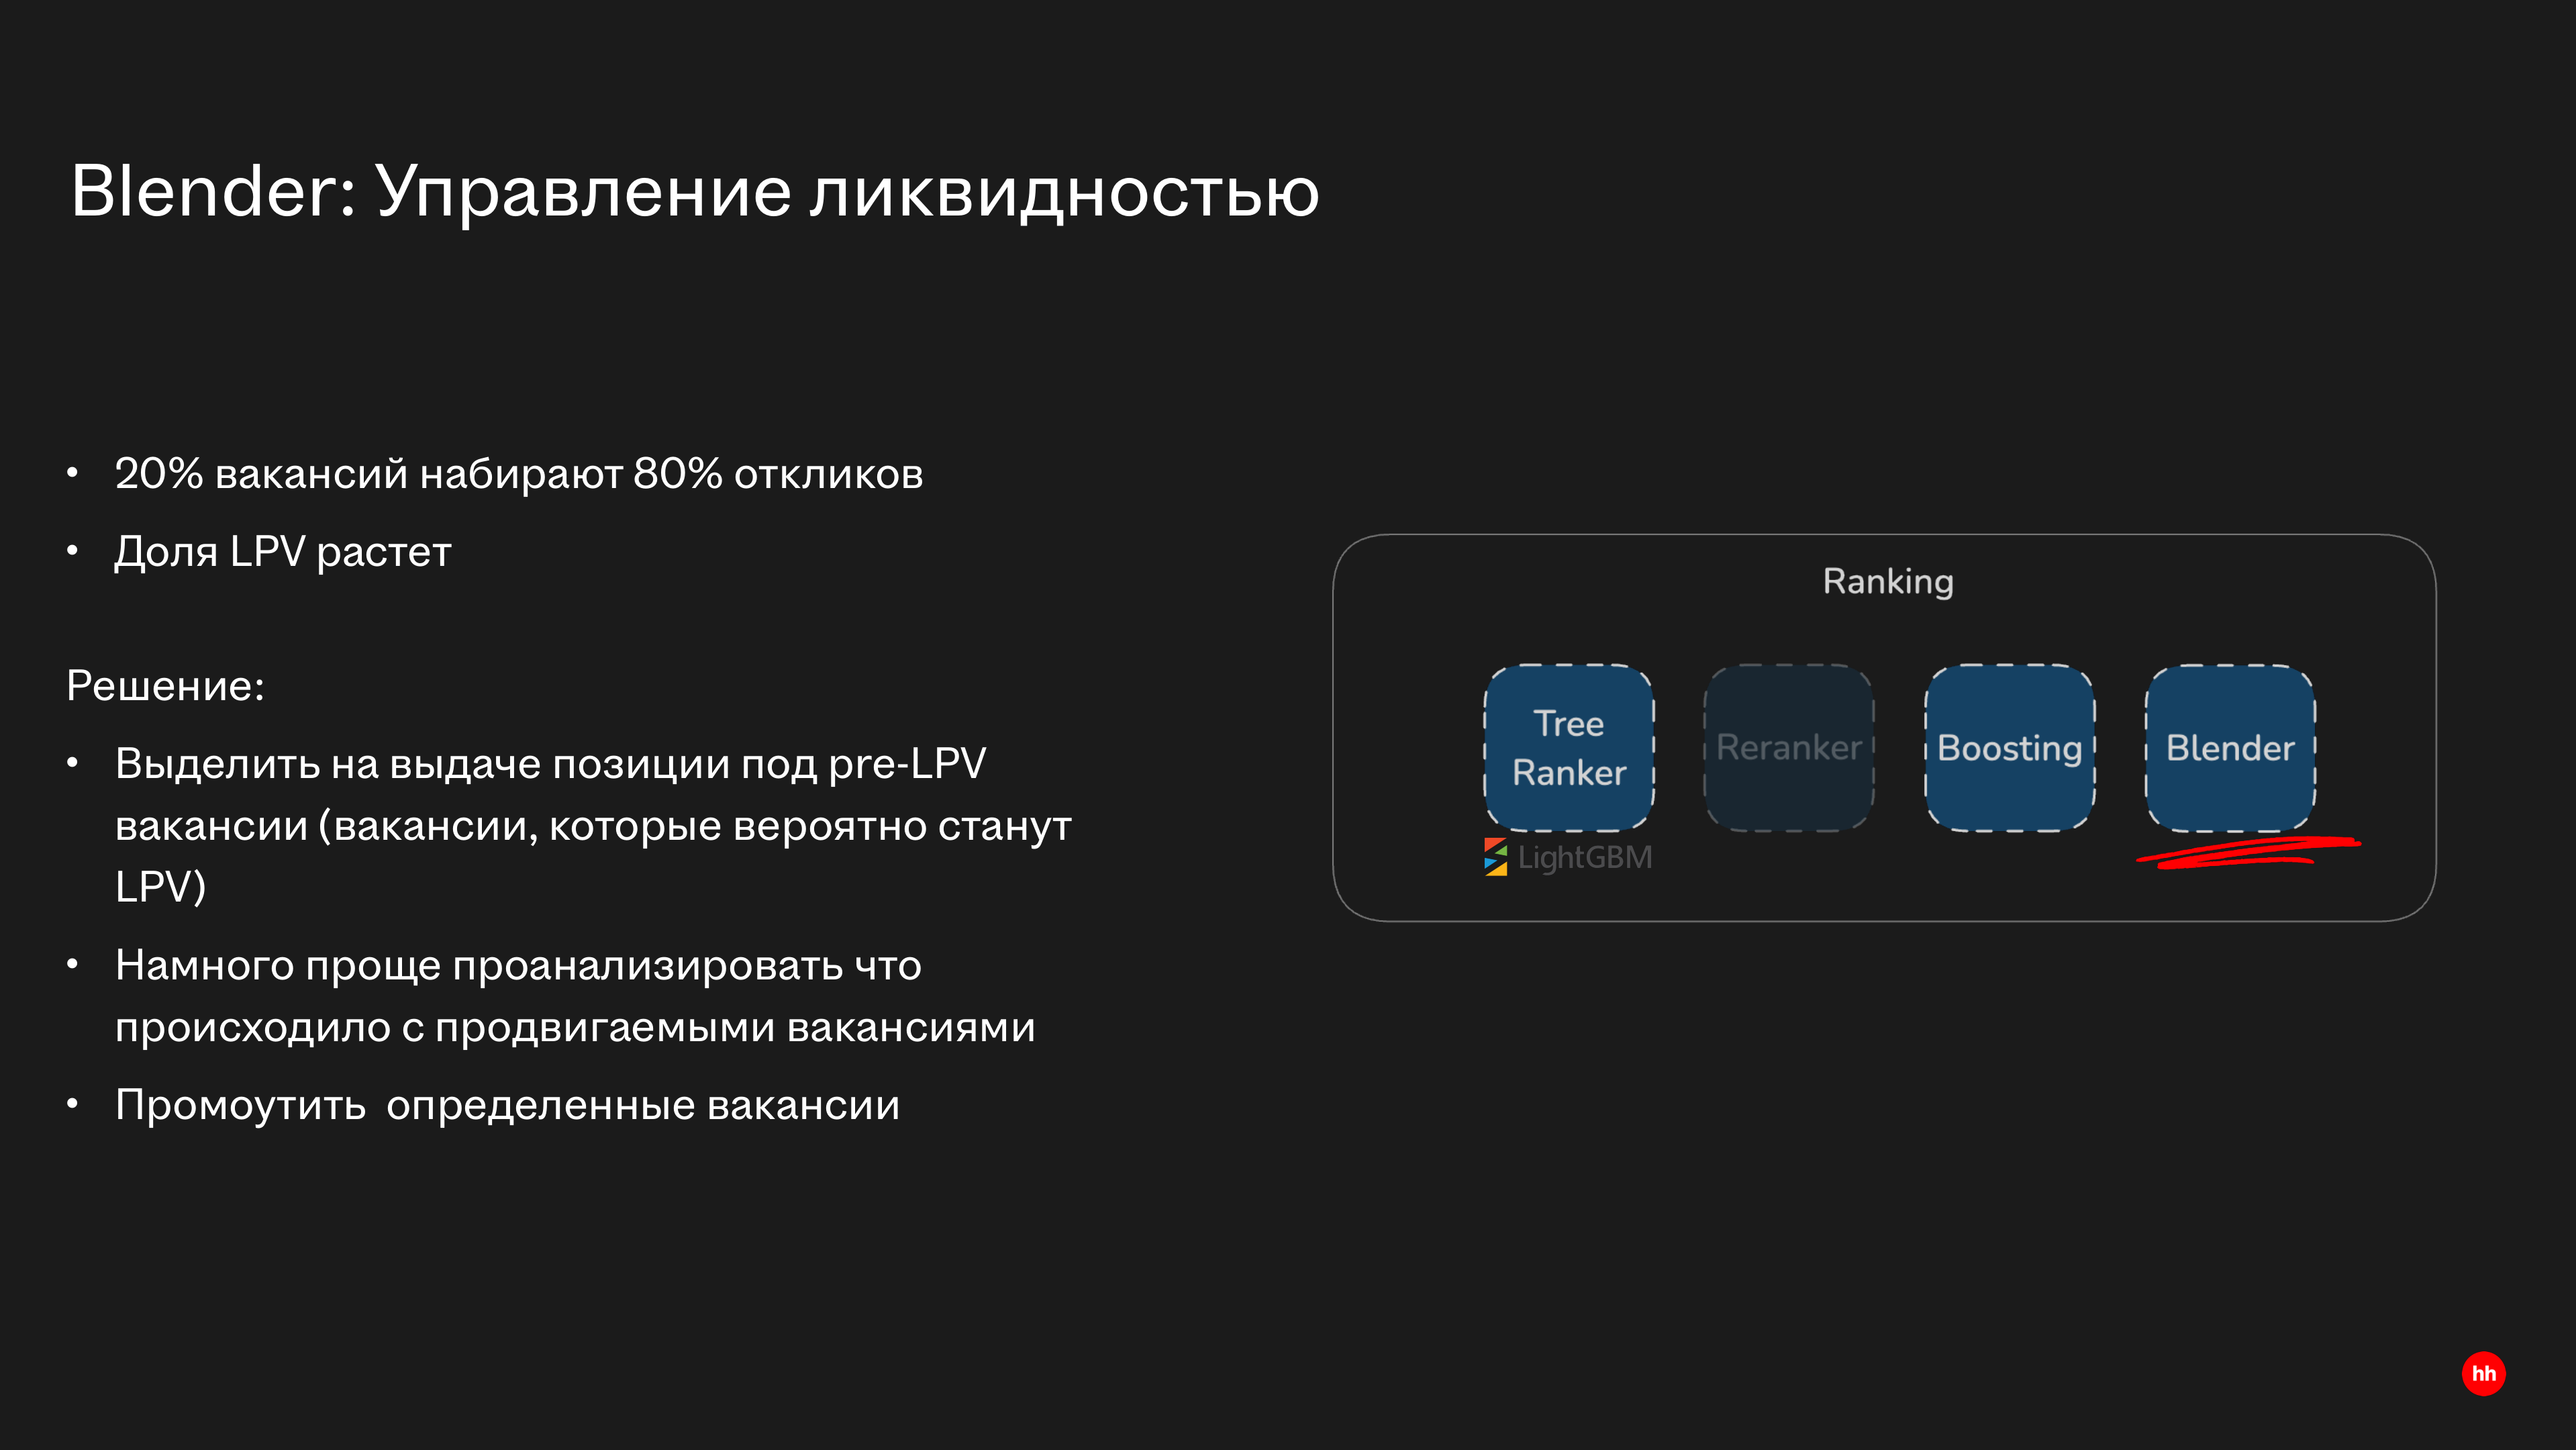
Распределение откликов между вакансиями.
Источник: Оригинал, страница 21Один текстовый фундамент обслуживает разные задачи
DSSM связывает тексты резюме и вакансий. Автор показывает собственную токенизацию и общий энкодер: отдельные сети для двух типов документов в их опыте были хуже. Представления переиспользуются для поиска похожих вакансий и резюме, персонализации и других задач.
Результаты экспериментов относятся к описанным данным hh.ru. Они не доказывают, что общая сеть всегда сильнее двух раздельных.
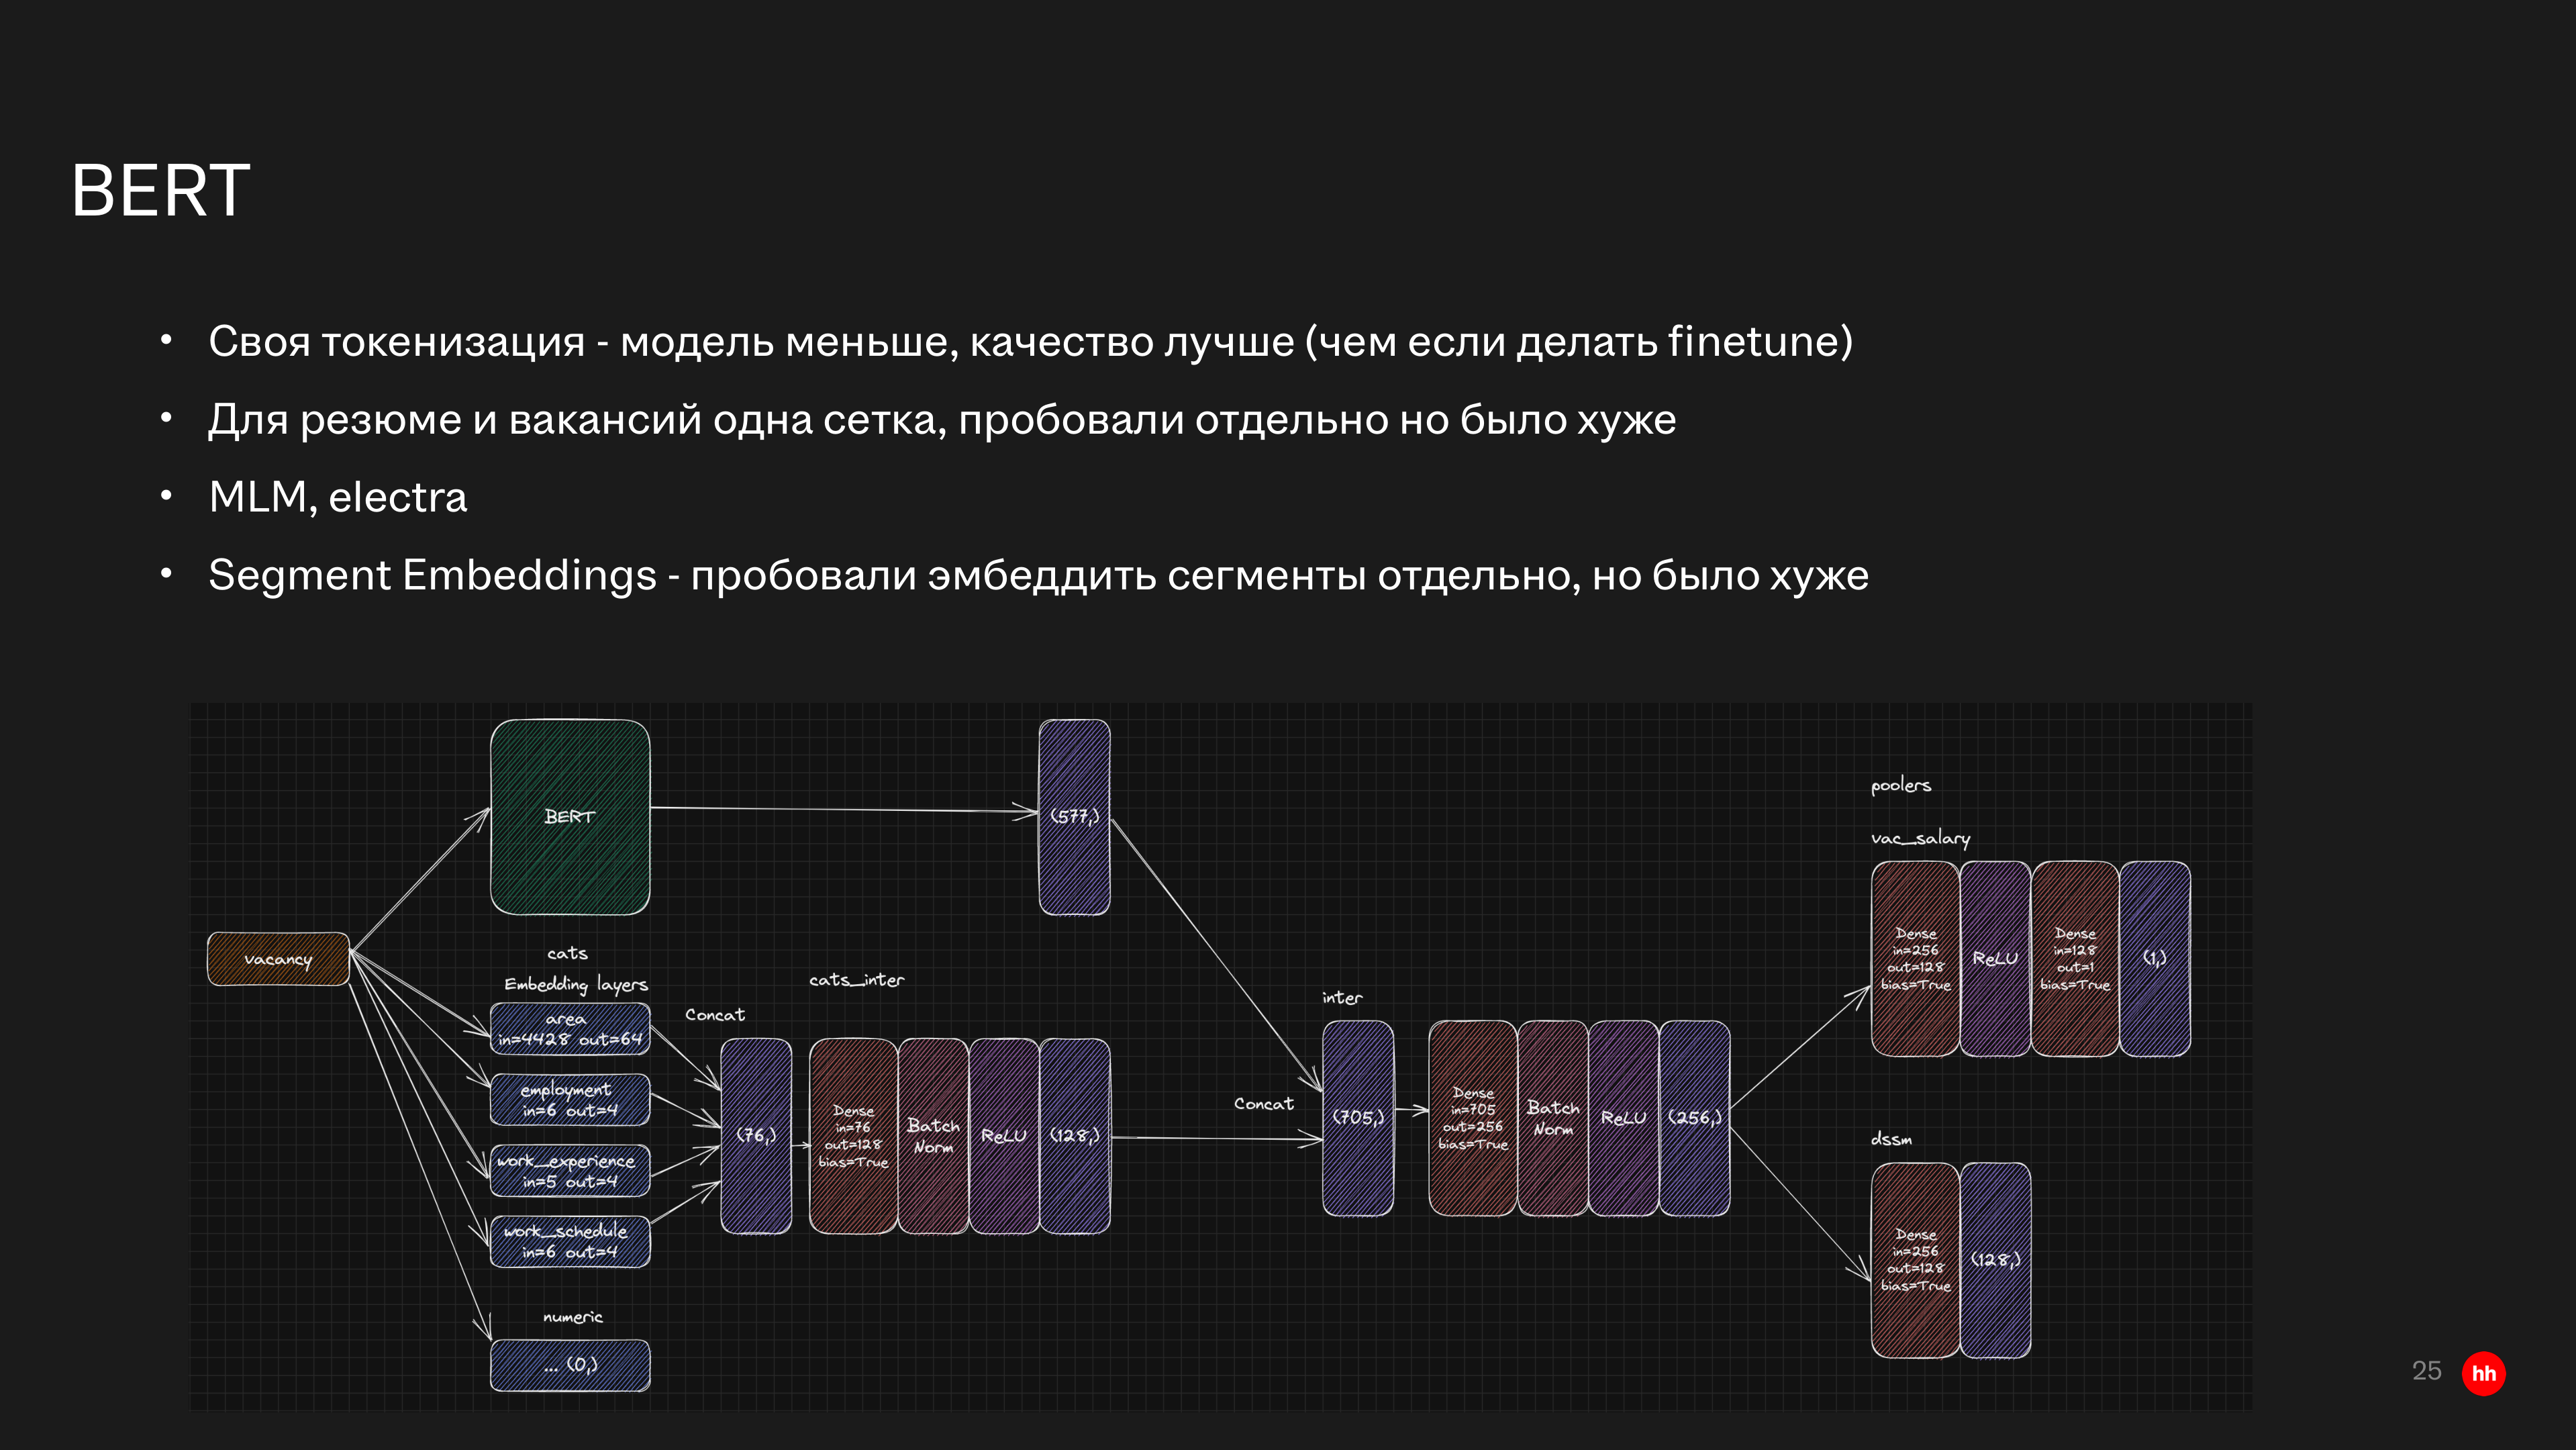
Общее текстовое представление на основе BERT.
Источник: Оригинал, страница 25Трансформер зависит от направления рекомендаций
Для рекомендаций вакансий при каталоге около 1,5 млн объектов обучали близкий к классическому SASRec с ID-векторами. Он оказался полезнее как дополнительный источник кандидатов, чем как новый признак ранжирования.
Для рекомендаций резюме к вакансии каталог превышал 40 млн объектов. Использовали двухбашенную схему: последовательность представлений взаимодействовавших резюме из DSSM агрегировал трансформер. Это разные постановки, хотя в обеих присутствует история.
Разные способы применения SASRec.
Источник: Оригинал, страница 36Быстрое сравнение не заменяет A/B-тест
В дополнительных слайдах разобран Team-Draft Interleaving: перемешивание выдач помогает чувствительно сравнивать близкие гипотезы на меньшем трафике. Но оно не оценивает абсолютный продуктовый эффект, плохо подходит к изменению фильтров и иногда расходилось с A/B.
Видеозапись конференции требует доступа. Этот разбор основан на публичных слайдах; недоступные устные пояснения не восстановлены по догадке.
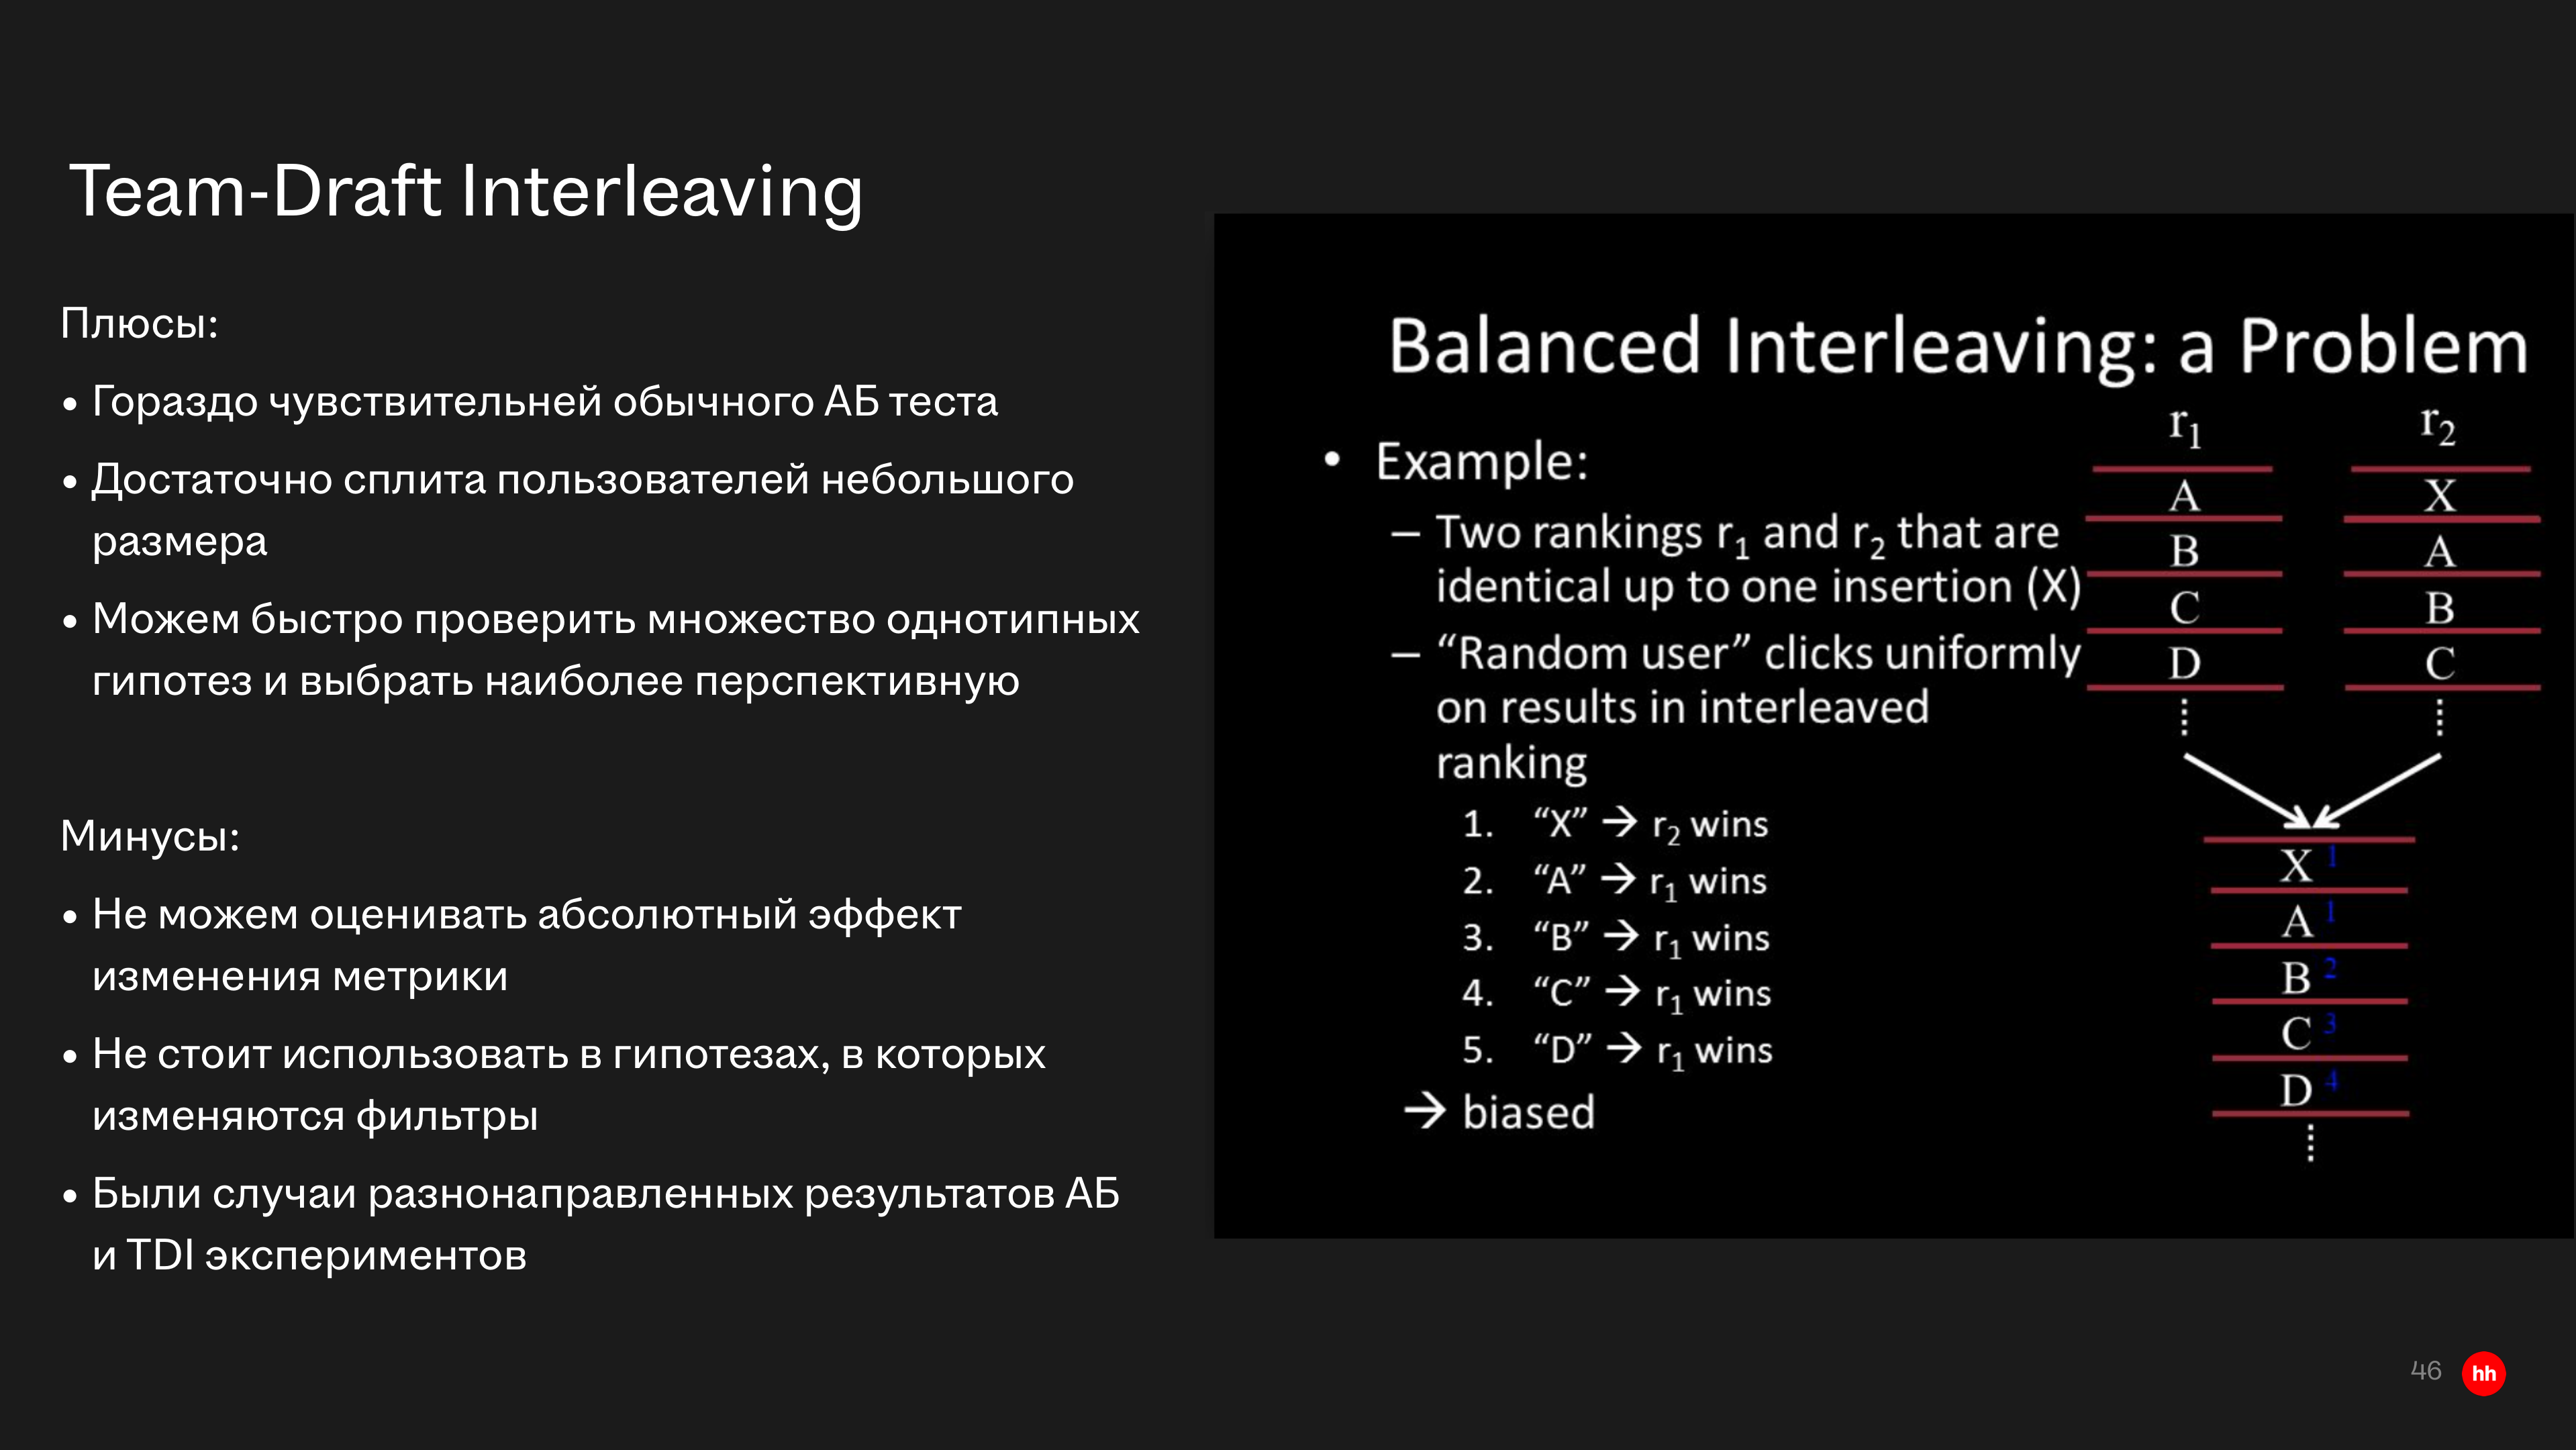
Ограничения быстрого сравнения ранжировщиков.
Источник: Оригинал, страница 46