Доматчинг товаров с использованием LLM: от промптов до квантизации
ecom.tech сопоставляет товары для заведения карточек, группировки и мониторинга цен. Статья описывает проверку сложных пар: выбор LLM, разметку, дообучение и ускорение.
Статья · на русском
Доматчинг товаров с использованием LLM: от промптов до квантизацииКоманда продуктового матчинга ecom.tech · AleksaPro · Опубликовано: 27 января 2026 г.
Где возникают сложные пары
Предварительный поиск сравнивает изображения. Визуально похожие товары могут различаться размером, длиной или диоптриями. Через LLM пропускают отобранные пары, а не весь многомиллионный каталог.
Читать в оригиналеВыбор модели
Нужны русский язык, возможность дообучения и приемлемая скорость на одной A100. Команда проверила девять открытых моделей; работа без дообучения не устроила. Выбрали текстовую модель около 8B. Её настоящее название в статье скрыто.
Читать в оригиналеКлассы и разметка
Вместо двух исходов используются четыре: от точного совпадения до точного несовпадения. Для разных задач принимают разные классы. По категориям составили правила с важными и второстепенными атрибутами.
Собрали 4200 пар. Написание подробных объяснений вручную оказалось слишком затратным, поэтому использовали разметку моделью по подготовленным инструкциям.
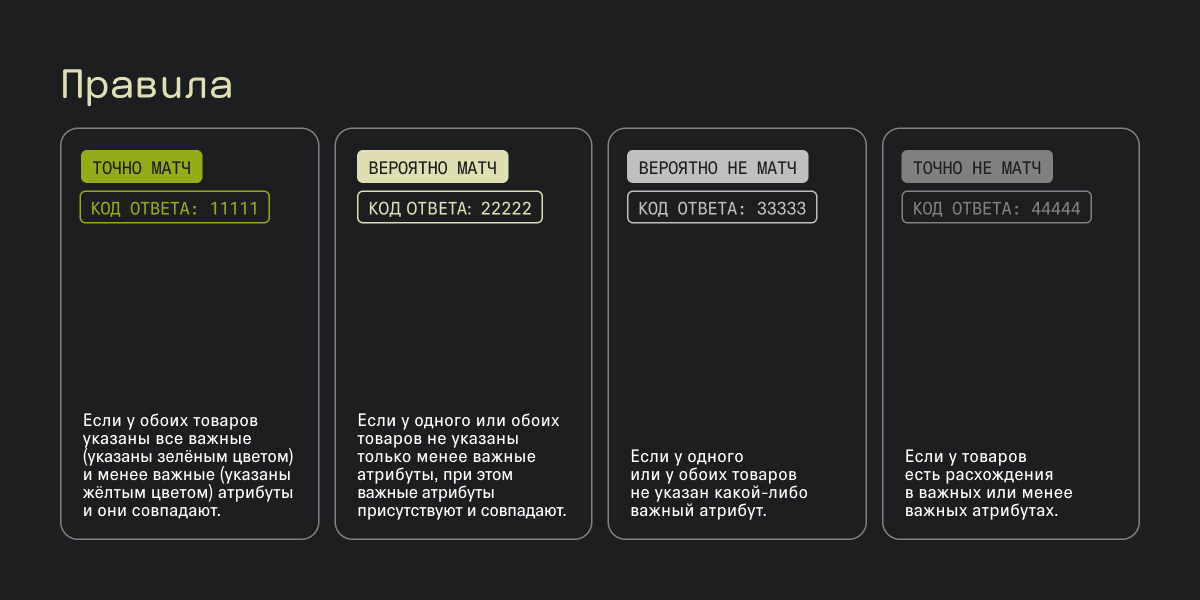
Четыре класса совпадения товаров и правила выбора ответа — схема ecom.tech.
Источник: ecom.tech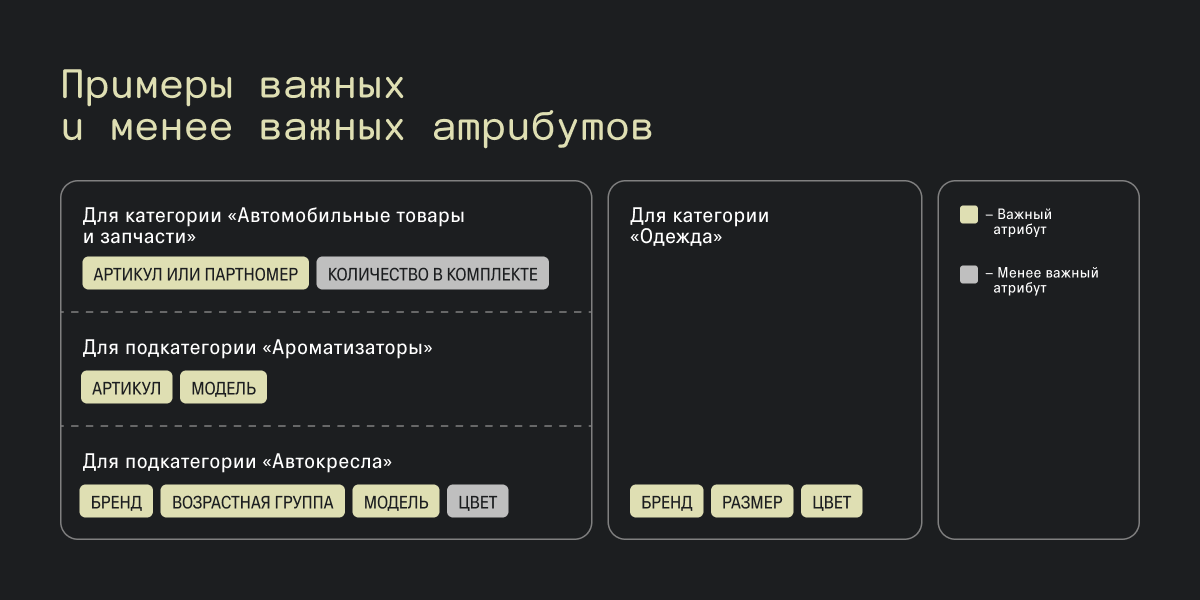
Важные и второстепенные атрибуты для разных товарных категорий — примеры из статьи.
Источник: ecom.techДообучение и ускорение
После обучения LoRA-адаптеров команда подбирала их параметры и способ запуска модели. На наборе из 200 пар vLLM потребовал 15,5 минуты, SGLang — 11 минут. Затем сравнили QAT и GPTQ с разной разрядностью и настройками группировки. Лучшим оказался GPTQ в 8 бит: в этой конфигурации авторы получили почти полуторакратное ускорение и улучшение качества относительно несжатой модели. Это результат их испытания, а не общее свойство любой квантизации.
Читать в оригиналеРезультаты на тестовой выборке
Таблицу можно прокрутить по горизонтали.
Уточнение правил
После анализа ошибок добавили недооценённые атрибуты, например количество в упаковке. Такие уточнения вносили в инструкции без нового обучения адаптера.
Пары, которые текстовая модель посчитала совпадающими, дополнительно проверяет мультимодальная InterVL-8B. Она рассматривает изображения: надпись со вкусом кофе, оттенок, пуговицы или небольшие различия формы могут не отражаться в текстовых атрибутах. Авторы сообщают примерно о 8% улучшения качества после этой проверки, но не определяют здесь точную метрику — её нельзя отождествлять с F1 из таблицы.
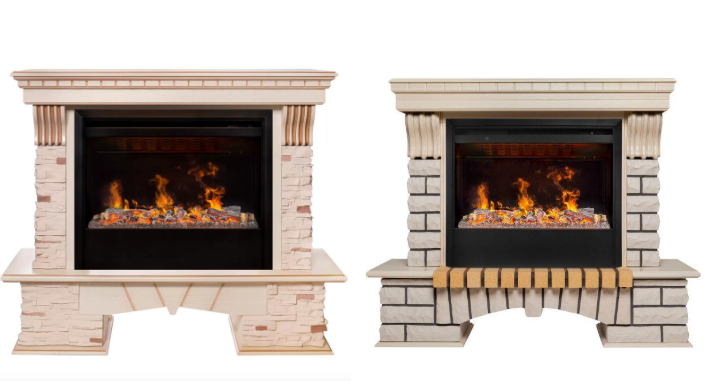
Пример пары каминов из раздела об анализе ошибок.
Источник: ecom.tech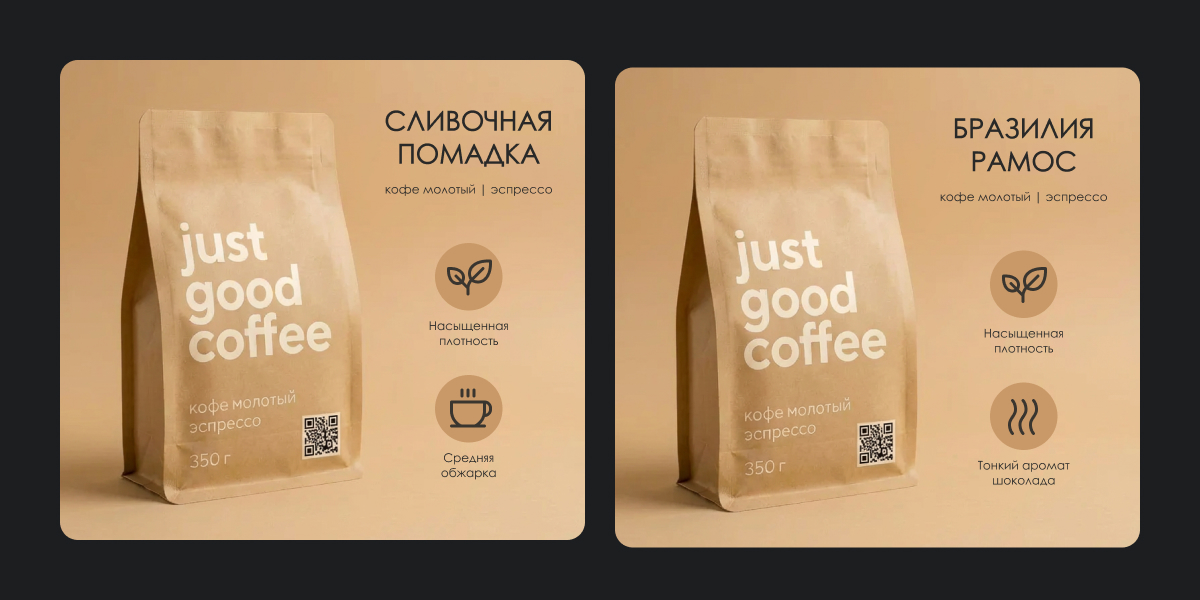
Пример похожих упаковок кофе из исходной статьи: изображения похожи, но названия продуктов различаются.
Источник: ecom.techКак проверка повлияла на рабочий конвейер
Дополнительную проверку подключили после основного матчинга: выбирают пары с достаточно близкими изображениями и пропускают их через текстовую и мультимодальную модели. Порог позволяет регулировать объём работы с учётом доступных вычислений.
По данным авторов, охват матчинга вырос на 8% при точности 83%. Для другой задачи — объединения похожих товаров в группы — охват вырос на 14,7% при точности 97,4%. Это два разных сценария с разными правилами совпадения; эти значения не складываются с изменением F1 на тестовой выборке.
Этот фрагмент в оригинале