Как Cloud.ru добавила ответы по технической документации
Три облачные платформы и десятки сервисов создают объём документации, в котором трудно быстро найти ответ. Постоянно переучивать LLM при каждом обновлении дорого. Команда объединила полнотекстовый и векторный поиск, обучила ранжирование под свой домен и наладила ежедневное обновление базы.
Видео · на русском
Михаил Дремин, Петр Королев | Как мы завели RAG в продакшенеМихаил Дремин, Пётр Королёв · Опубликовано: 11 октября 2024 г.
Исходный доклад · Открыть оригинал
Сначала найти, затем ответить
Из документации выбирают подходящие фрагменты и передают их генератору вместе с вопросом. В расширенной схеме два поиска работают параллельно: BM25 ловит текстовые совпадения, векторная модель — смысловые. Общий список пересортировывает отдельная модель, которая читает вопрос и фрагмент вместе.
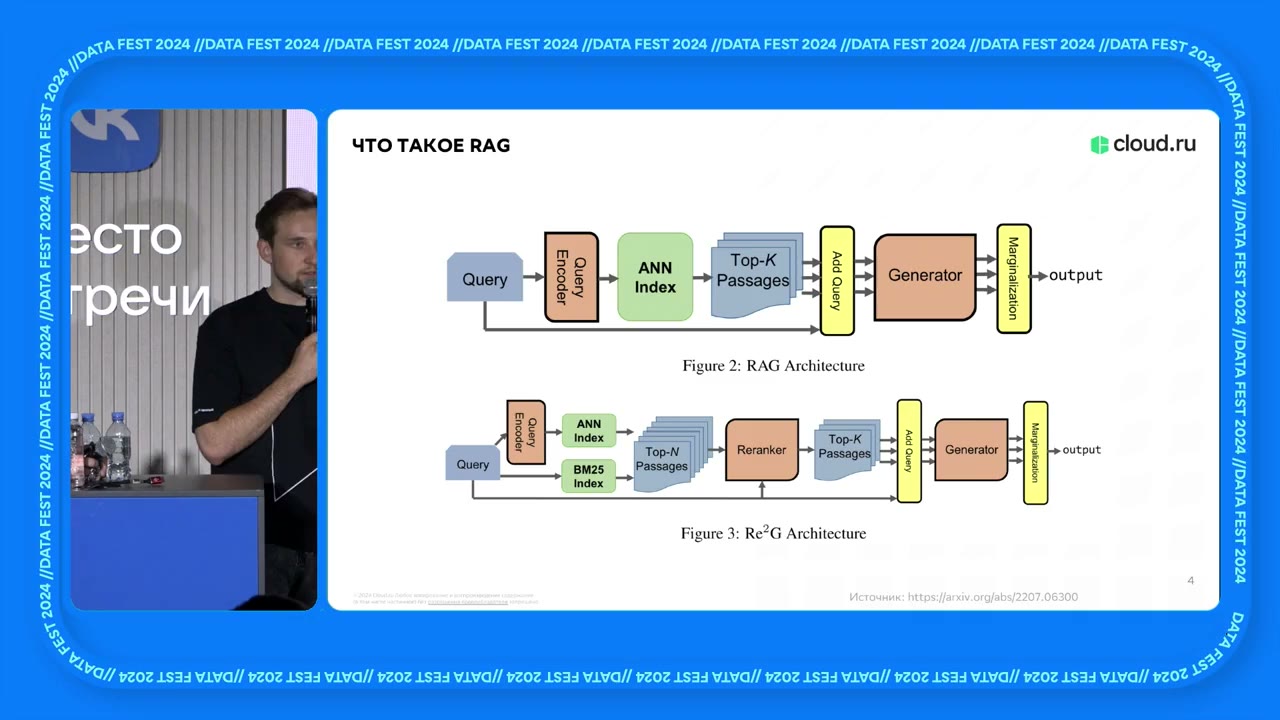
Поиск документов и генерация ответа.
Источник: Кадр из докладаРейтинг модели не заменяет проверку токенизации
При выборе учитывали, сколько русских слов помещается в ограниченное окно модели. Хорошая модель из общего рейтинга могла обрезать большую часть документа и ухудшить результат.
Кросс-энкодер сначала обучили на переведённом поисковом датасете, затем на собственных оценках релевантности от 0 до 3. Добавляли перефразировки и ошибки в запросах. Эксперты проверяли подготовленные примеры, а не создавали всю разметку с нуля.
04:00 — фрагмент докладаСинтетика для поиска и словарь для терминов
Для настройки векторного поиска использовали GPL: модель генерирует вопросы по фрагменту, действующий поиск находит похожие конкурирующие тексты, кросс-энкодер оценивает пары. Обучение сближает вопрос с более подходящим текстом, учитывая разницу оценок.
Но синтетика не решила все проблемы терминологии. В полнотекстовый поиск добавили словарь технических писателей: «виртуальная машина», VM и разговорные варианты должны находить нужную документацию. Дополнительно применили обработку форм слов и поиск по сочетаниям слов.
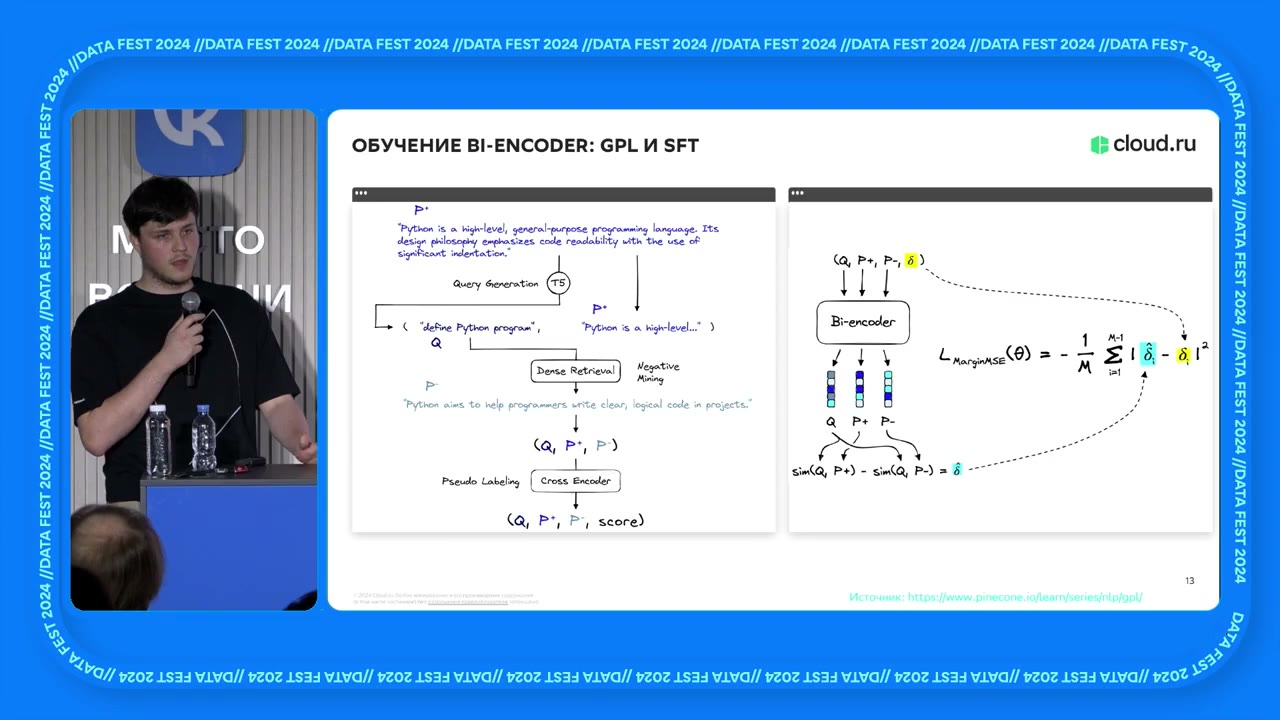
Дообучение модели поиска.
Источник: Кадр из доклада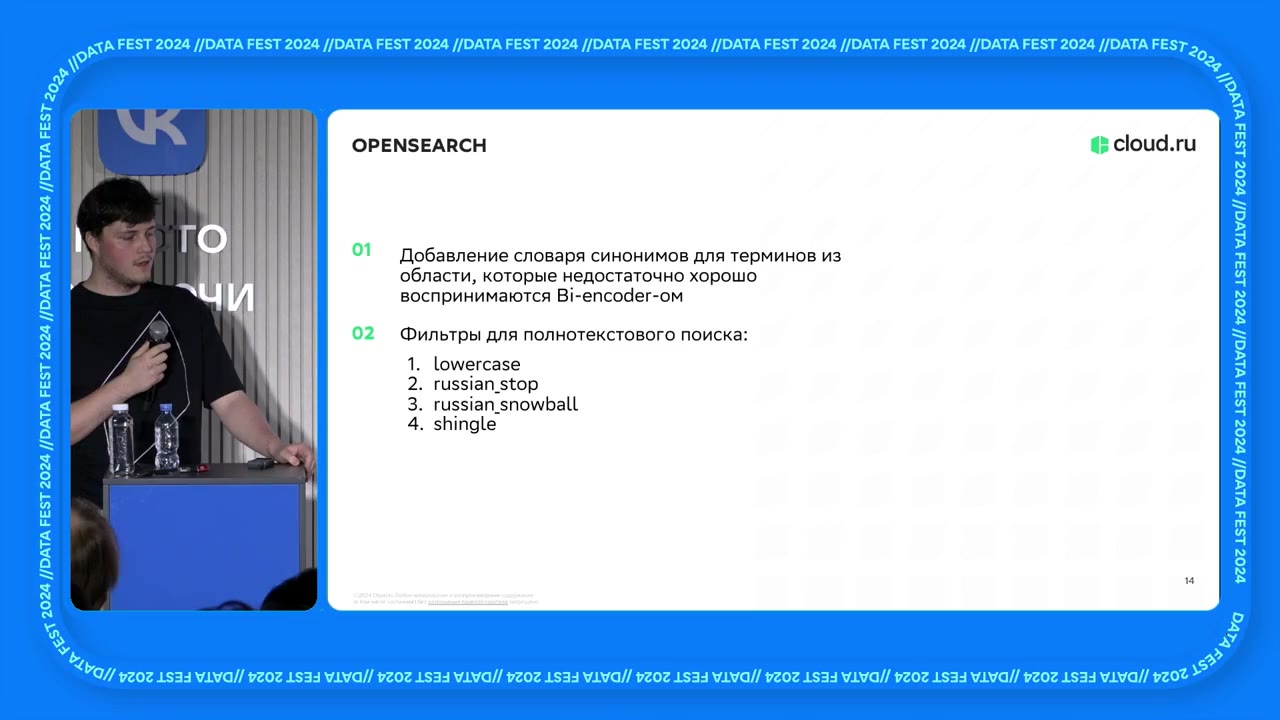
Обработка терминов и синонимов в OpenSearch.
Источник: Кадр из докладаТри фрагмента оказались полезнее длинной подборки
Генератору передают три лучших фрагмента. При увеличении их числа модель иногда терялась среди несвязанных документов. Поэтому качество поиска оценивали для верхней части выдачи, действительно поступающей в генерацию.
Основное улучшение после объединения двух поисков пришло от обучения кросс-энкодера: нужные тексты уже попадали в кандидаты, но занимали неправильные позиции.
12:00 — фрагмент докладаОбновление знаний — отдельный производственный процесс
HTML режут по заголовкам от H1 до H6, затем по абзацам. Длину считают в токенах наиболее ограниченной модели, чтобы не обрезать значимый термин. Результат библиотечных разделителей проверяют: команда встречала и ошибки, и несовместимые обновления.
Prefect раз в день забирает документацию из GitLab, подготавливает фрагменты и обновляет OpenSearch и Milvus. Модели обслуживает Triton, компоненты работают в Kubernetes. Такой процесс важен не меньше выбора LLM: ответ должен опираться на действующую версию документации.
15:00 — фрагмент доклада