Как разнообразить главную ленту, сохранив интерес пользователя
После обычной сортировки похожие объявления собирались в длинные однотипные блоки и вытесняли другие интересы покупателя. Авито сначала добавила смешивание категорий, затем заменила ручные веса компактным трансформером.
Статья · на русском
Нейросетевая модель интересов пользователя: как мы улучшили разнообразие и релевантность рекомендаций на главной АвитоЯрослав Хныков · Опубликовано: 9 декабря 2025 г.
Почему хорошие оценки дают однообразную ленту
Ранжировщик оценивает объявления по отдельности. Похожие товары получают близкие оценки и занимают соседние места, хотя второй почти такой же товар добавляет меньше пользы, чем первый.
Первое решение сохранило порядок внутри каждой категории, но стало выбирать категорию следующего слота по интересам пользователя. Интерес считался из действий с весами и затуханием по времени. Сглаживание распределения позволяло регулировать разнообразие.
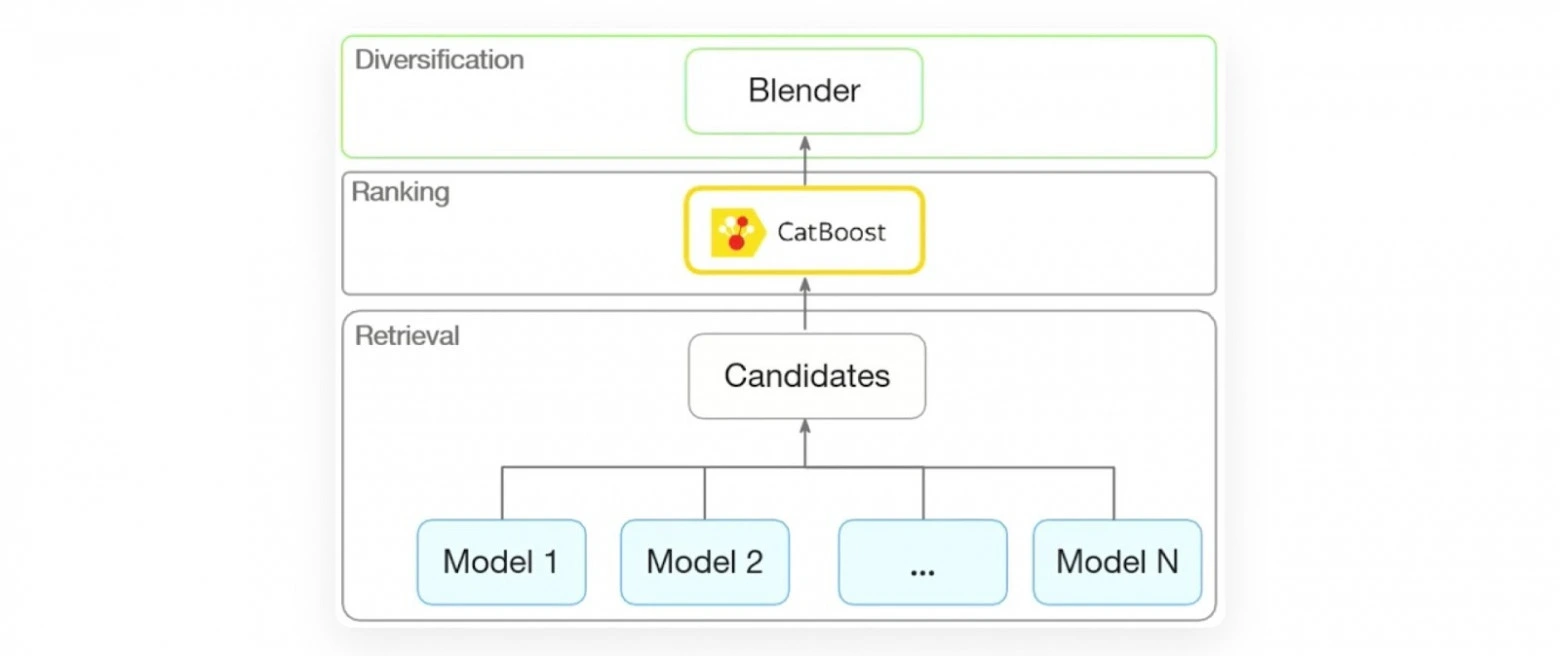
Место смешивания интересов в рекомендательной системе.
Источник: Иллюстрация из оригиналаЧто дала простая формула и чего ей не хватало
В A/B-тесте такой «блендер» дал +2,5% пользователей, связавшихся с продавцом, и +4% связавшихся в новой для себя категории. Это сравнение с лентой без блендера.
Но формула видела только уже встречавшиеся категории, плохо предлагала дополняющие товары и медленно реагировала на смену намерения. Добавление нового сигнала требовало ещё одного ручного веса. Следующим шагом стало обучение распределения интересов.
Этот фрагмент в оригиналеКак выбрали момент и цель обучения
Вход — история на момент реального запроса главной или поиска. Цель — распределение добавлений в избранное и контактов по категориям за следующие семь дней. Просмотры исключили, чтобы не учиться на привлекательных, но бесполезных кликах.
Повторные действия с тем же объявлением очищали. Разделение обучения и проверки сделали по общей границе времени с дополнительным промежутком. Недельный горизонт — компромисс: слишком короткий плохо раскрывает дополняющие категории, слишком длинный уводит к общей популярности.
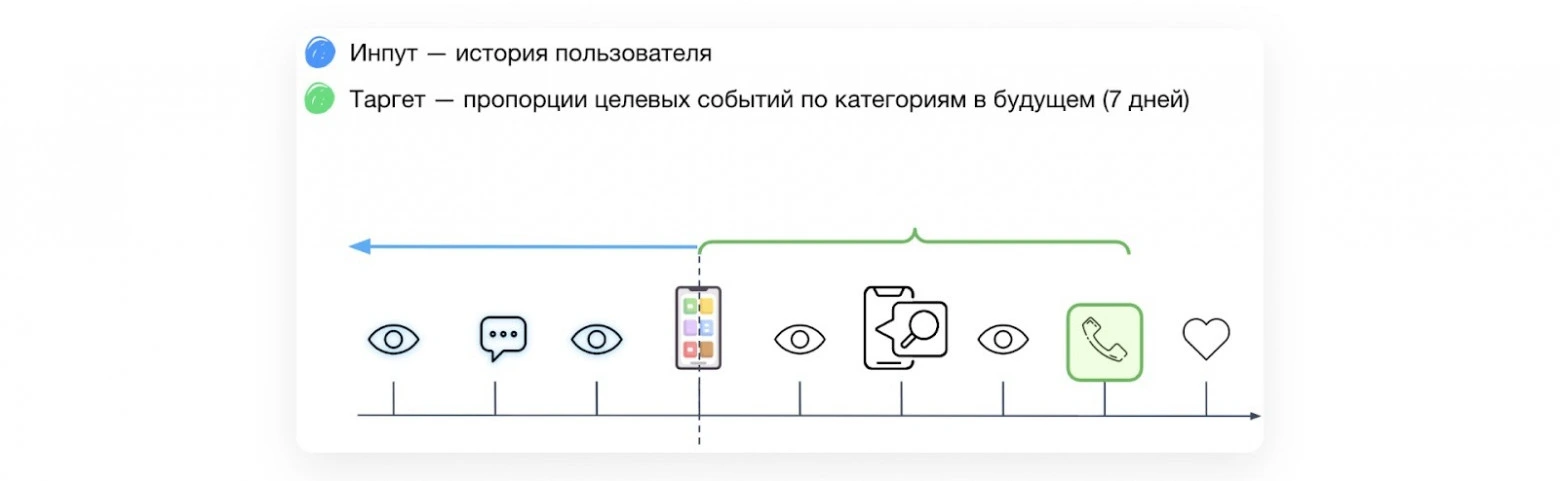
История событий и целевые действия пользователя.
Источник: Иллюстрация из оригиналаНебольшая модель для ответа в реальном времени
Событие кодируется суммой признаков, позиции и возраста. Позиции считают от свежего события к старому. Возраст переводят через небольшую сеть, чтобы модель сама выучила затухание интереса.
Двухслойный Transformer Encoder принимает до 512 событий с размерностью 64; параметров чуть больше миллиона. В описанном применении CPU-вызов укладывался в 10–20 мс. Перед смешиванием предсказания сглаживают температурным softmax: иначе история с одной активной категорией снова делает ленту узкой.
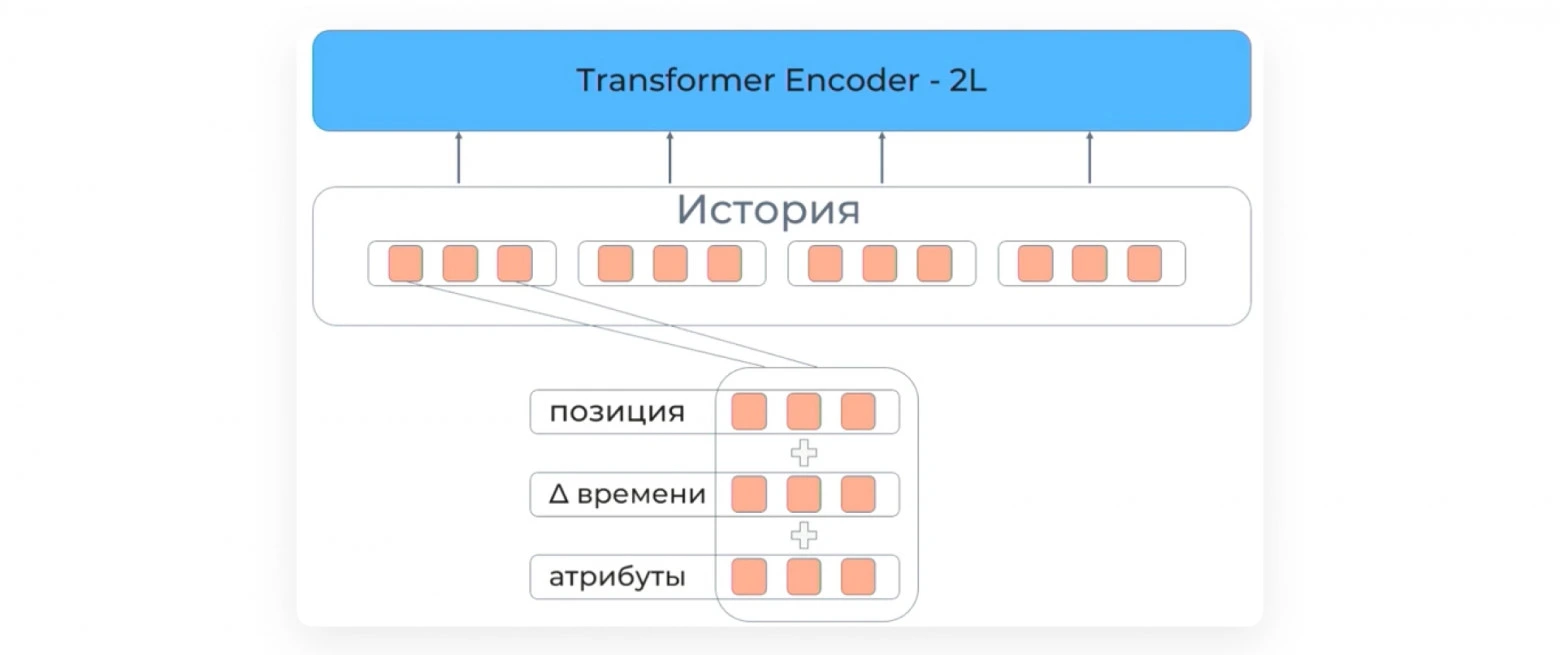
Небольшой трансформер для оценки интересов.
Источник: Иллюстрация из оригиналаРезультаты второго шага
По сравнению с ручной формулой офлайн-метрики ранжирования категорий выросли на 5–7%. В A/B-тесте получили ещё +1% пользователей с контактом, +0,6% с контактом в новой категории и −2,5% скрытий с причиной несоответствия категории.
Это эффект замены эвристики моделью, а не повторное сравнение с исходной лентой. Результаты двух последовательных изменений нельзя складывать без учёта разных баз сравнения.
Этот фрагмент в оригинале