Как AiGenda приспособила Mistral 7B к русскоязычным встречам
После встречи нужно восстановить решения, задачи и темы обсуждения. Базовая Mistral ошибалась в русском языке и плохо следовала инструкциям. Команда разделила работу над языком, форматом протокола и распознаванием речи.
Статья · на русском
LoRA не помогла: как мы дообучали Mistral 7B на русском и что в итоге сработалоЕвгений Гутин · Опубликовано: 31 марта 2026 г.
От записи встречи к протоколу
Сервис сначала распознаёт речь с помощью Whisper, затем определяет участников и делит разговор на темы. Для разделения говорящих использовали pyannote/speaker-segmentation и ResNet34, обученную на VoxCeleb. Смену темы определяли по расстоянию между векторными представлениями предложений.
Текст обрабатывает модель размером до 7 млрд параметров с контекстом не менее 8 тысяч токенов. Команда выбрала Mistral 7B, но её качество на русском оказалось недостаточным: ошибки затрагивали и грамматику, и выполнение инструкций.
Этот фрагмент в оригиналеКак устроили сервис
Пользователь обращается к Backend; тот передаёт работу ML-сервисам через очередь RabbitMQ. Отдельный ML Controller направляет запросы нужным моделям и работает с векторной базой, где хранятся представления текста и голосов. Основная база пользователей и доступ к S3 остаются за Backend.
Запись видеоконференций вынесена в Meeting Controller: он выделяет ресурсы через OpenStack API. Это позволяет менять модели и масштабировать обработку отдельно от пользовательского приложения.
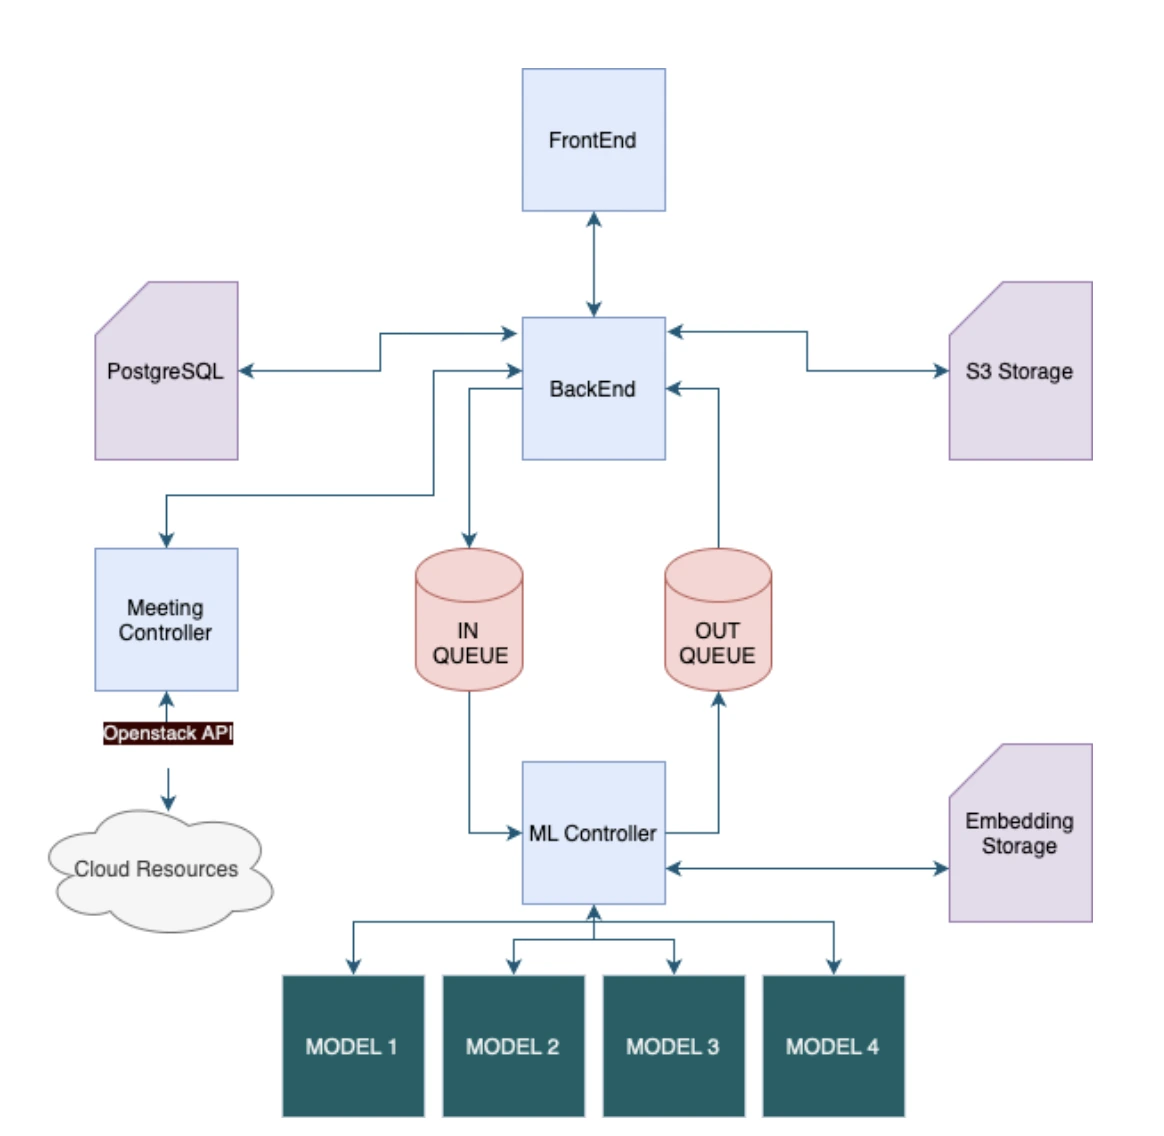
Устройство сервиса: очередь, обработка аудио и подготовка протокола.
Источник: Иллюстрация из оригиналаПочему одного адаптера оказалось мало
Сначала попробовали LoRA — обучение небольшого набора добавочных весов. В этом эксперименте она сгладила отдельные неточности, но не исправила слабую связность русских предложений. Поэтому команда перешла к дообучению всех весов Mistral. Это описание конкретного опыта, а не доказательство, что LoRA в принципе не подходит для языковой адаптации.
Для продолжения обучения собрали 5,35 млрд токенов: открытые тексты, диалоги, инструкции и переводы. Использовали две RTX A6000 по 48 ГБ, bfloat16, Flash Attention 2, упаковку примеров без лишнего заполнения и ZeRO-2 с выгрузкой на CPU. Несмотря на заголовок оригинала «с нуля», речь идёт о дообучении готовой модели.
Этот фрагмент в оригиналеОтдельное обучение под формат встречи
После языковой адаптации LoRA использовали снова — уже для трёх конкретных выходов: краткого содержания, задач и тем. В обучающие данные вошли многоязычные диалоги с ручными аннотациями и ответами GPT-4. Существенной разницы между проверенными настройками адаптера автор не обнаружил.
Качество русского языка проверяли на MERA, а суммаризации — с помощью BERTScore F1; для неё опубликовано значение 0,93. Эта метрика сравнивает смысловую близость текстов и сама по себе не проверяет каждое поручение или имя.
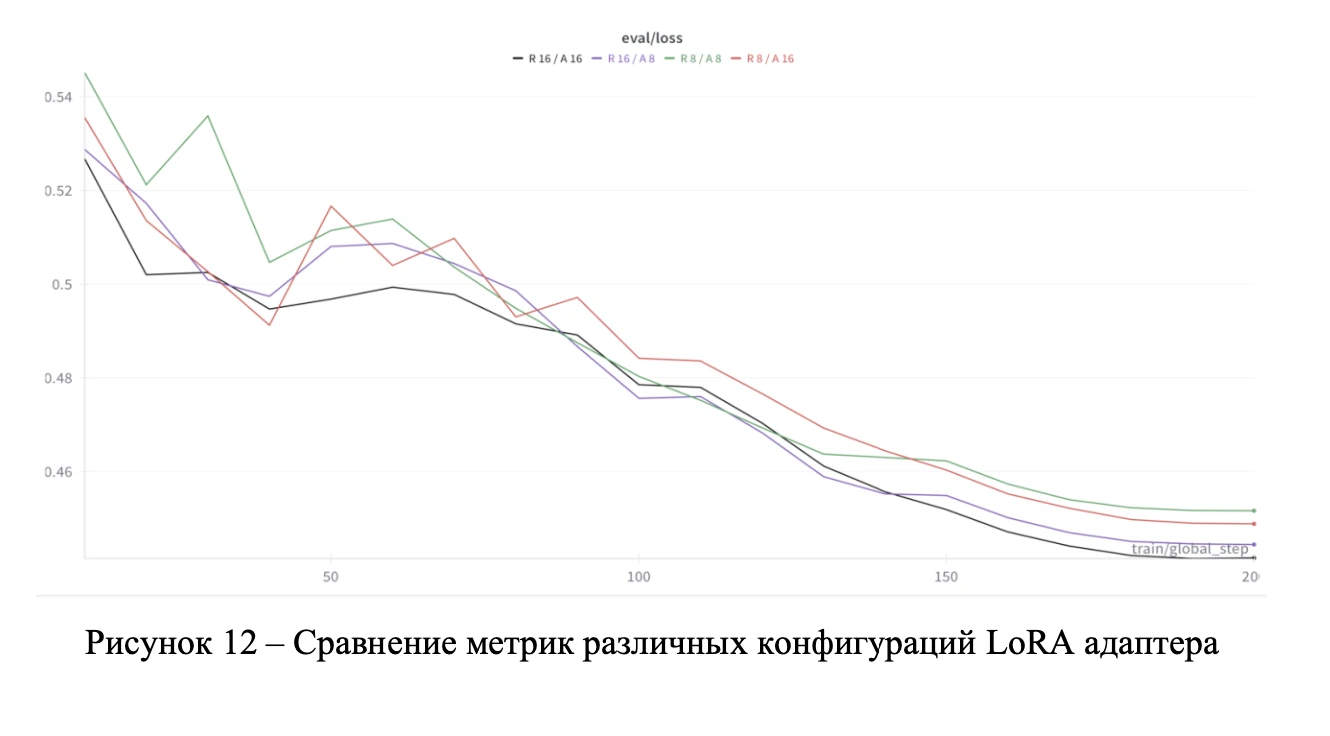
Сравнение вариантов дообучения из статьи.
Источник: Иллюстрация из оригиналаПочему пришлось менять и распознавание речи
Плохой звук и шум встреч влияли на весь последующий протокол. Whisper дообучали на лекциях, конференциях и интервью; больше половины корпуса составляла русская речь. Автоматические расшифровки исправляли вручную, а словарь помогал подсвечивать подозрительные названия, например замену «ИТМО» на «ЭТМО».
В конце статьи увеличение контекста до 128 тысяч токенов и переход к новым базовым моделям названы планами. Их нельзя считать уже полученным результатом этого обучения.
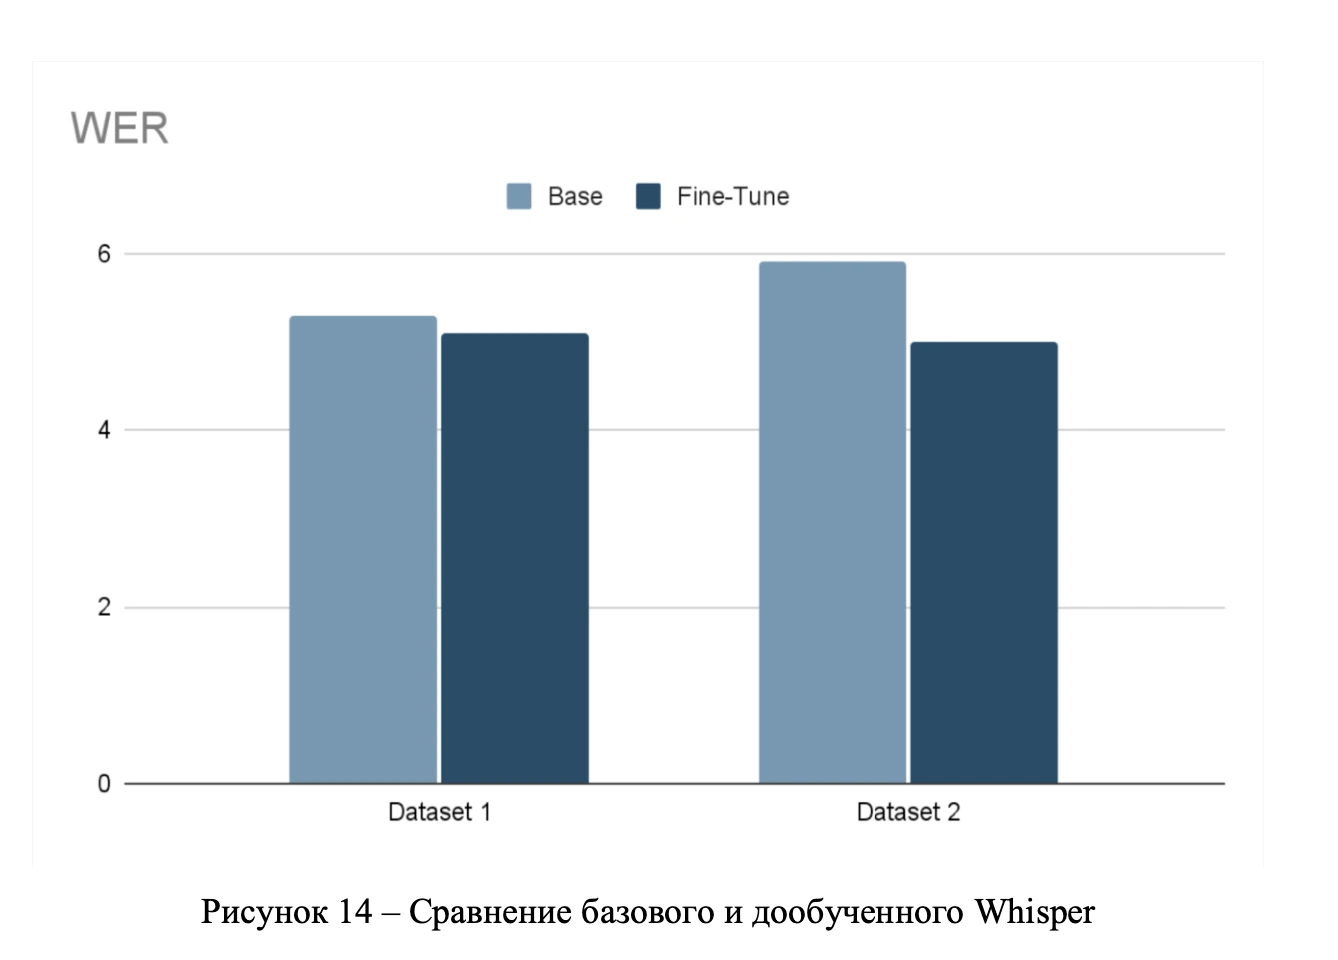
Ошибки распознавания речи на тестах авторов.
Источник: Иллюстрация из оригинала